Anticipation des risques et prévention des incidents
Découvrez un processus prévu reliant les signaux de surveillance à la détection des anomalies, à la hiérarchisation des risques et à des indications sur les causes profondes probables pour les équipes opérationnelles.
Un scénario de la feuille de route fondé sur le cas d'usage CIRMS GL5 d'origine. Il ne s'agit ni d'un déploiement en production ni d'un résultat garanti.
Rapprochez les signaux avant de décider de la réponse à apporter.
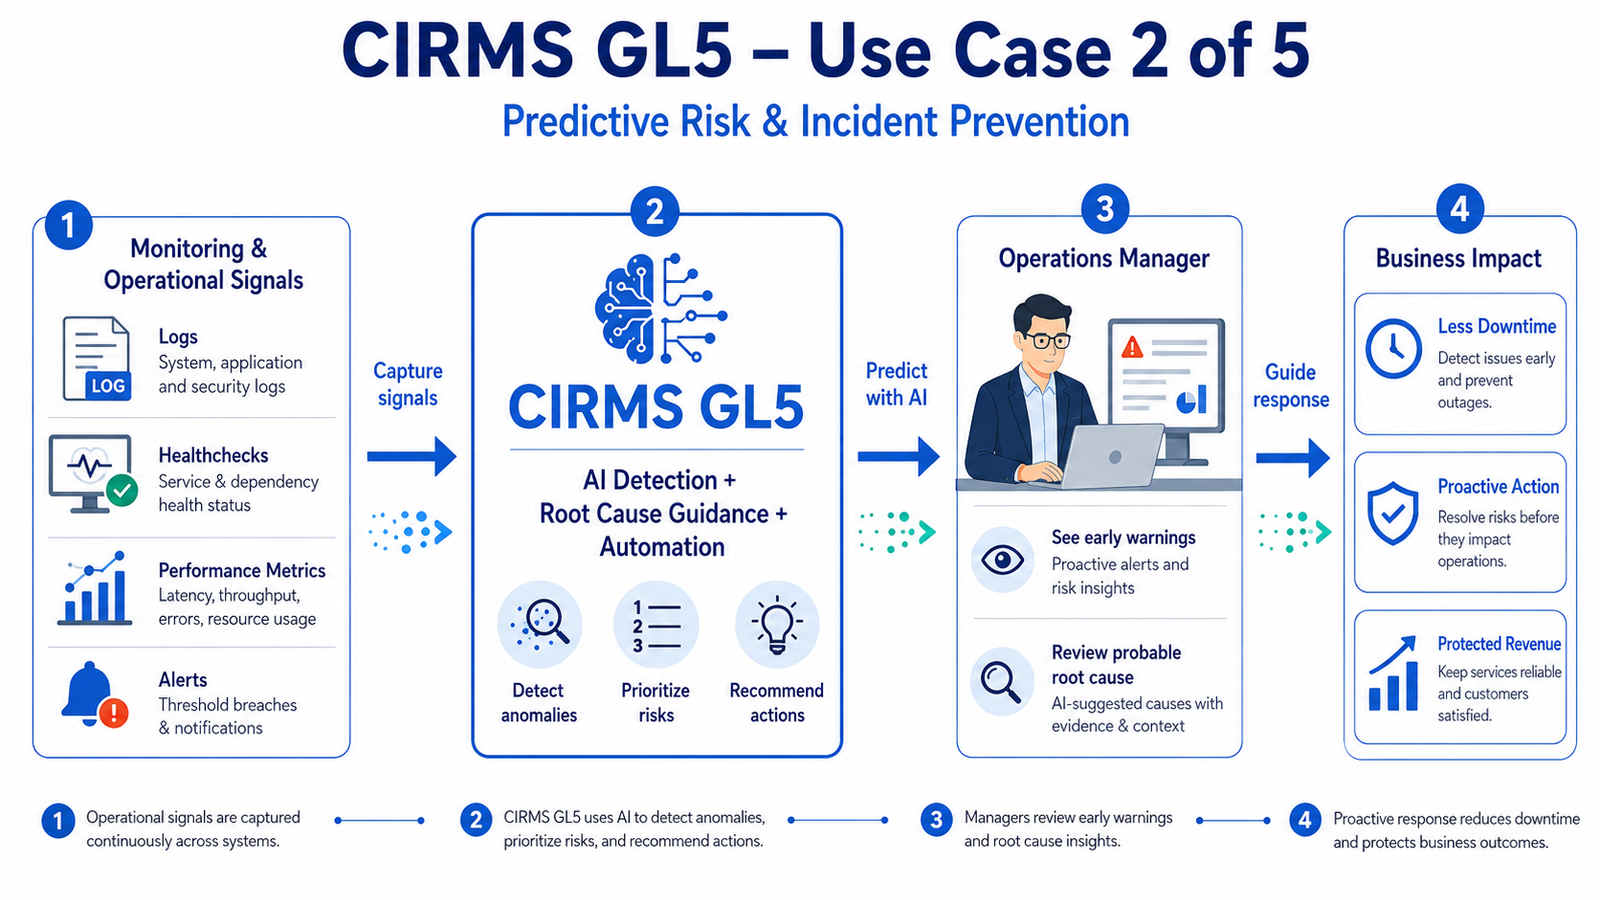
Les journaux, les contrôles de bon fonctionnement, les indicateurs de performance et les alertes peuvent révéler des symptômes différents d’un même problème. Ce concept GL5 propose de réunir ces signaux pour faciliter une réponse examinée et hiérarchisée.
Informations dans le périmètre
- Journaux
- Enregistrements des systèmes, des applications et de la sécurité dans le périmètre convenu.
- Contrôles de bon fonctionnement
- Informations disponibles sur l’état des services et de leurs dépendances.
- Indicateurs de performance
- Latence, débit, erreurs et utilisation des ressources.
- Alertes
- Franchissements de seuils, notifications et contexte des incidents.
Comment le scénario pourrait fonctionner.
Suivez le parcours proposé, des informations approuvées à un examen assisté par l'IA, puis à une décision dont les personnes restent responsables.
- 01
Collecter les signaux opérationnels
Collecter les journaux, contrôles, indicateurs et alertes convenus.
- 02
Explorer la détection prévue dans GL5
Aider à détecter les anomalies, à hiérarchiser les risques et à envisager des actions.
- 03
Examiner les causes probables
Les responsables des opérations examinent les éléments disponibles et testent d’autres explications.
- 04
Autoriser une réponse
Utiliser des procédures approuvées et vérifier le rétablissement plutôt que de supposer que le problème est résolu.
Investigation plus précoce
Aider les équipes à se concentrer sur les signaux qui méritent leur attention.
Réponse hiérarchisée
Évaluer l’impact probable et les éléments qui l’étayent avant d’agir.
Continuité de service
Viser une réduction des perturbations grâce à une réponse examinée et à un suivi.
Le concept d'origine du cas d'usage.
Ce qui sous-tend le cas d'usage.
Distinguez le socle de la plateforme de l'intelligence prévue et des exigences de l'environnement cible.
GL3 / GL4 & architecture
La surveillance GL3, les contrôles de bon fonctionnement, les alertes et l’automatisation opérationnelle constituent la base. GL4 prépare les informations historiques et contextuelles sélectionnées à une utilisation par l’IA.
IA & extensions futures
La notation prédictive des risques, la détection des anomalies par l’IA et les suggestions de causes profondes probables sont des extensions GL5 prévues. Une prédiction ne prouve pas un lien de causalité et ne garantit pas qu’un incident sera évité.
Personnes, données & autorisations
Convenir des intervalles de collecte, de la qualité des signaux, des responsabilités liées aux alertes et des autorisations de réponse. Tester les faux positifs et les incidents non détectés ; définir des procédures sûres de retour arrière et d’escalade avant toute action.
Une évaluation délimitée
Examiner un ensemble délimité d’incidents historiques et de résultats connus avant d’envisager un processus de gestion des incidents assisté par l’IA en conditions réelles.
Mesures possibles : délai d’anticipation de la détection, taux de fausses alertes, durée d’investigation et temps de rétablissement vérifié. Cette page ne donne aucune garantie concernant les temps d’arrêt ou le chiffre d’affaires.