Predicción de riesgos y prevención de incidentes
Explore un flujo de trabajo previsto que conecta las señales de monitorización con la detección de anomalías, la priorización de riesgos y la orientación sobre causas raíz probables para los equipos de operaciones.
Un escenario de la hoja de ruta basado en el caso de uso original de CIRMS GL5. No es una implementación en producción ni un resultado garantizado.
Relacione las señales antes de decidir cómo responder.
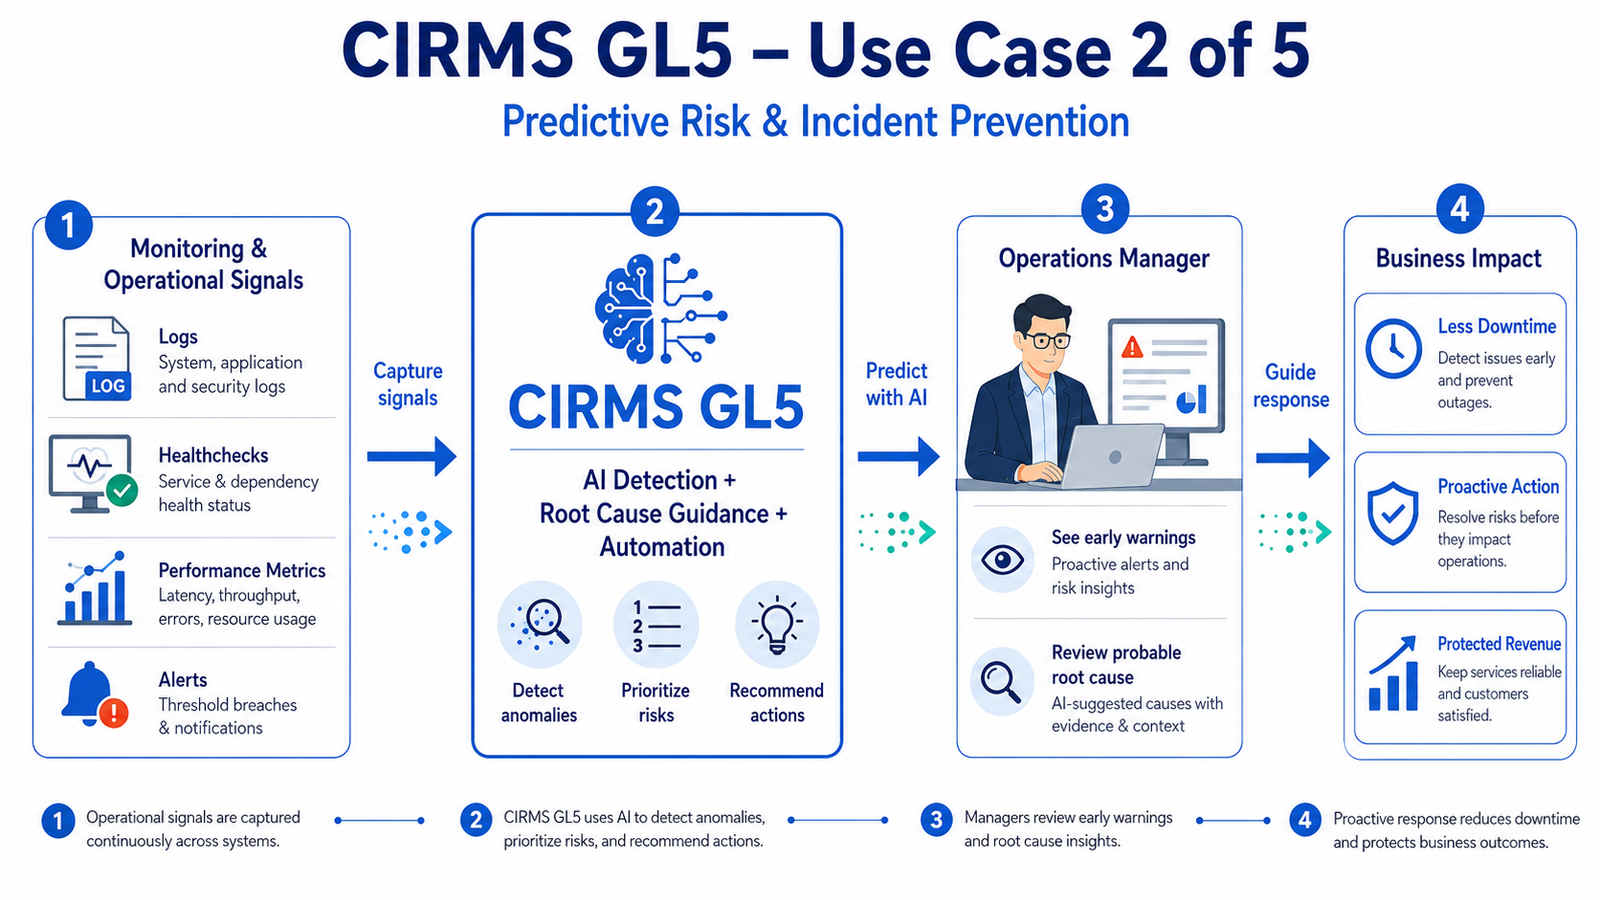
Los registros, las comprobaciones de estado, las métricas de rendimiento y las alertas pueden mostrar síntomas distintos de un mismo problema. Este concepto de GL5 propone reunir esas señales para apoyar una respuesta revisada y priorizada.
Información incluida en el alcance
- Registros
- Registros de sistemas, aplicaciones y seguridad dentro del alcance acordado.
- Comprobaciones de estado
- Información disponible sobre el estado de los servicios y sus dependencias.
- Métricas de rendimiento
- Latencia, tasa de procesamiento, errores y uso de recursos.
- Alertas
- Superaciones de umbrales, notificaciones y contexto de los incidentes.
Cómo podría funcionar el escenario.
Siga el recorrido propuesto desde la información aprobada hasta una revisión asistida por IA y una decisión cuya responsabilidad recae en las personas.
- 01
Capturar señales operativas
Recopilar los registros, las comprobaciones, las métricas y las alertas acordados.
- 02
Explorar la detección prevista de GL5
Ayudar a detectar anomalías, priorizar riesgos y proponer posibles acciones.
- 03
Investigar las causas probables
Los responsables de operaciones revisan las evidencias y ponen a prueba explicaciones alternativas.
- 04
Autorizar una respuesta
Utilizar procedimientos aprobados y verificar la recuperación, en lugar de asumir que el problema está resuelto.
Investigación más temprana
Ayudar a los equipos a centrarse en las señales que merecen atención.
Respuesta priorizada
Evaluar el impacto probable y las evidencias que lo respaldan antes de actuar.
Continuidad del servicio
Buscar una reducción de las interrupciones mediante una respuesta revisada y su seguimiento.
El concepto original del caso de uso.
Qué hay detrás del caso de uso.
Distinga la base de la plataforma de la inteligencia prevista y de los requisitos del entorno de destino.
GL3 / GL4 y arquitectura
La monitorización, las comprobaciones de estado, las alertas y la automatización operativa de GL3 proporcionan la base. GL4 prepara la información histórica y contextual seleccionada para su uso con IA.
IA y futuras extensiones
La puntuación predictiva de riesgos, la detección de anomalías mediante IA y las sugerencias de causas raíz probables son extensiones previstas de GL5. Una predicción no demuestra causalidad ni garantiza que se evitará un incidente.
Personas, datos y permisos
Acordar los intervalos de recopilación, la calidad de las señales, la responsabilidad sobre las alertas y la autorización de respuestas. Evaluar los falsos positivos y los incidentes no detectados; definir procedimientos seguros de reversión y escalado antes de actuar.
Una evaluación delimitada
Revisar un conjunto acotado de incidentes históricos y resultados conocidos antes de considerar un flujo de gestión de incidentes asistido por IA en producción.
Métricas posibles: tiempo de anticipación de la detección, tasa de falsas alertas, tiempo de investigación y tiempo de recuperación verificado. La página no ofrece garantías sobre el tiempo de inactividad ni los ingresos.